GPT‑6 Cyber, безопасность интеграций и оценка ИИ в лаборатории
Дата выпуска:
В выпуске — две новости о киберзащите и исследование о работе ИИ с лабораторными данными. Сообщение о GPT‑6 Cyber опубликовано 5 ноября и перенесено из предыдущего выпуска.
Выпуск может включать ранее опубликованные важные события.
OpenAI представила GPT‑6 Cyber для исследований безопасности
Ранее опубликованное событие ·
OpenAI представила модель для поиска и проверки уязвимостей и подготовки исправлений. Изначально она доступна через API и Codex только отдельным одобренным клиентам Daybreak Red.
Ключевые факты
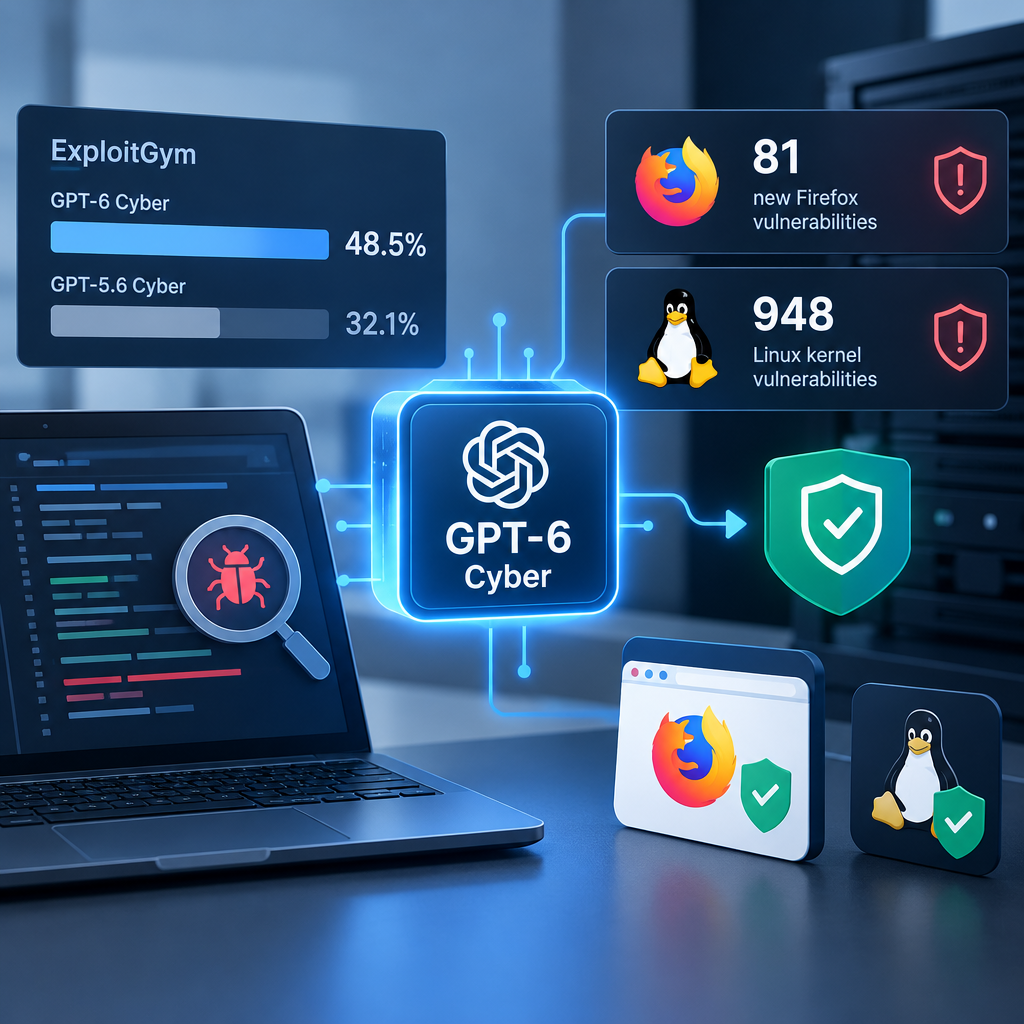
По данным OpenAI, в тесте ExploitGym модель набрала 48,5% против 32,1% у GPT‑5.6 Cyber. Тест проверяет способность использовать заданную уязвимость.
OpenAI сообщает, что исследователи с помощью модели выявили 81 ранее неизвестную серьёзную уязвимость Firefox и разработали работающие эксплойты для 948 уязвимостей ядра Linux. Mozilla выпустила исправления для многих проблем Firefox.
По данным OpenAI, в тесте ExploitGym Honeypot модель не пыталась использовать сервисы вне рамок задания в 99,93% испытаний без защитной инструкции и в 100% — с ней.
Объективно о важном
Специализированная модель может помочь командам безопасности проверять крупные кодовые базы и готовить исправления, но результаты тестов не гарантируют безопасной работы в каждом задании.
Бизнес-процессы
Проверка кода и устранение уязвимостей — Команда может быстрее получать варианты проверки и исправления для последующего анализа.
Возможности автоматизации
Поиск уязвимостей и подготовка исправлений: ИИ может выполнять часть проверок и предлагать исправления под контролем специалиста. Условия: Нужен доступ для одобренного клиента Daybreak Red.; Для рискованных задач нужны изолированная среда, проверка действий и контроль человека.; Для API по умолчанию разрешены запросы только с одобренных IP-адресов.
Влияние на ручную работу
Часть исследований и подготовки исправлений может требовать меньше ручных действий, но экономия времени не измерена.
Ограничения и риски
Модель способна помогать в разработке эксплойтов, поэтому важны разрешённые границы тестирования и защита от злоупотреблений.
Клиенты API с нулевым хранением данных обычно должны использовать Private Safety Processing: зашифрованные записи хранятся у клиента 30 дней для автоматических проверок.
OpenAI и Hacktron будут искать уязвимости на стыке сервисов
OpenAI объявила о партнёрстве с Hacktron для поиска уязвимостей в своих системах. Инженеры OpenAI и исследователи Hacktron совместно выберут приоритетные области проверки, уделяя особое внимание связям со сторонними сервисами.
Ключевые факты
В рамках партнёрства OpenAI расширяет доступ Hacktron к своим передовым моделям через Daybreak Red.
Hacktron разрабатывает ИИ-агентов для проверки кода, тестирования на проникновение и имитации атак.
Объективно о важном
Проверка связей между сервисами важна для организаций, чьи агенты и приложения взаимодействуют с внешними системами: уязвимость может возникнуть именно на стыке.
Бизнес-процессы
Проверка безопасности интеграций — Команды могут включить взаимодействия со сторонними сервисами в приоритетные сценарии тестирования.
Возможности автоматизации
Проверка кода и связей между сервисами: ИИ-агенты могут помогать специалистам искать слабые места в рамках разрешённых проверок. Условия: Объявлено партнёрство для проверки систем OpenAI, а не готовое решение для других компаний.; Для проверок нужны согласованные границы и контроль специалистов.
Влияние на ручную работу
Партнёры не сообщили, сколько ручной работы удастся сократить.
Ограничения и риски
Результаты совместных проверок и их эффективность пока не опубликованы.
OpenAI и Ligo представили тест ИИ на лабораторных данных
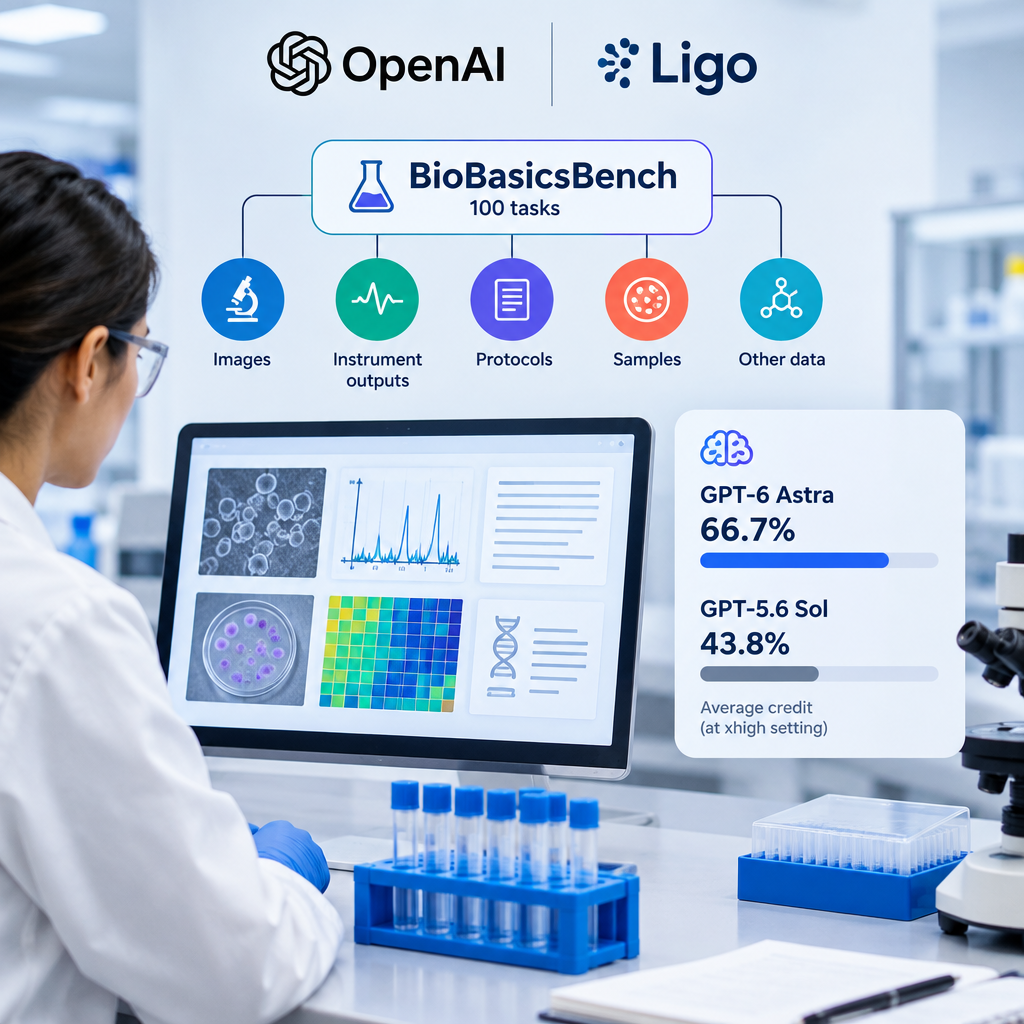
OpenAI и биотехнологическая компания Ligo представили BioBasicsBench — набор из 100 задач для оценки того, как ИИ-агенты анализируют данные реальных биологических экспериментов.
Ключевые факты
Задачи охватывают пять областей лабораторной работы и используют исходные данные, включая изображения, результаты приборов и протоколы. Ответы оцениваются по критериям, составленным экспертами.
По данным OpenAI, при настройке xhigh, выделяющей больше ресурсов на рассуждение, GPT‑6 Astra получила в среднем 66,7% возможных баллов, а GPT‑5.6 Sol — 43,8%.
OpenAI приводит примеры ошибок Astra: неверный выбор колоний и завышение их числа примерно на 12% в одном из заданий.
Объективно о важном
Тест помогает оценить не только ответы, но и способность модели замечать ошибки в эксперименте и признавать недостаточность данных.
Бизнес-процессы
Анализ лабораторных экспериментов — Лаборатории могут использовать подобные задачи для оценки ИИ-помощников перед внедрением.
Возможности автоматизации
Первичный анализ изображений и результатов приборов: ИИ может помогать готовить предварительный разбор данных, который затем проверит учёный. Условия: Специалист должен проверить выводы и то, как учтены контрольные условия эксперимента.; Показанные результаты относятся к тесту, а не к доказанному внедрению в лаборатории.
Влияние на ручную работу
Предварительный анализ может сократить ручную работу, но исследование не измеряет экономию времени.
Ограничения и риски
Высокий балл в тесте не означает, что модель может надёжно принимать самостоятельные лабораторные решения.
Ошибочная интерпретация изображений или контрольных условий эксперимента может привести к неверным выводам.