Images 2.6, поиск уязвимостей Linux и оценка ИИ в здравоохранении
Дата выпуска:
В выпуске: новые инструменты для визуальных материалов, исследовательский прототип для поиска уязвимостей и подход к проверке ответов ИИ на вопросы о здоровье.
Выпуск может включать ранее опубликованные важные события.
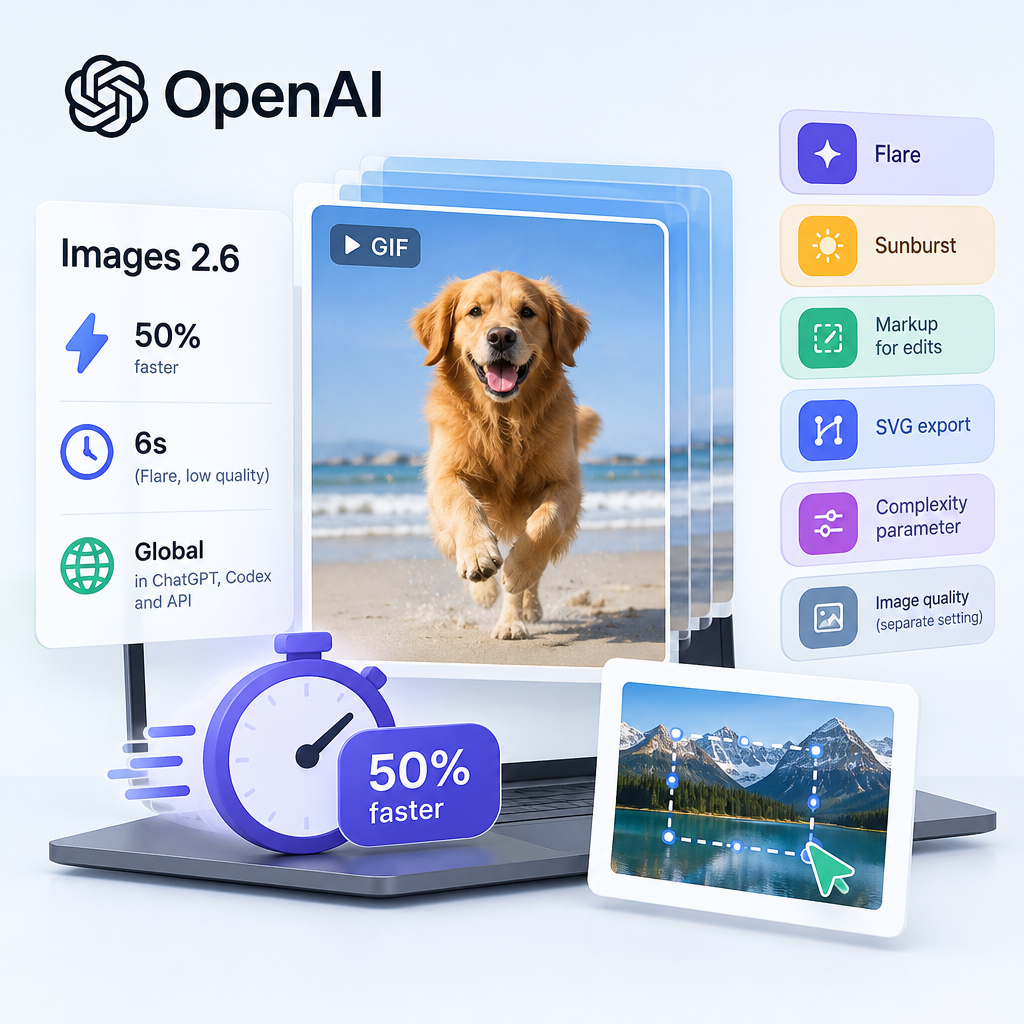
Images 2.6 доступна по всему миру в ChatGPT и Codex на всех тарифах, а также через API. Обновление добавляет создание GIF и новые способы редактирования изображений.
Ключевые факты
По заявлению OpenAI, Images 2.6 создаёт изображения на 50% быстрее, чем раньше. В API вариант Flare при низком значении настройки качества может создать изображение всего за шесть секунд.
В API доступны Flare и Sunburst, разметка областей для правок, экспорт SVG и параметр сложности, который задаёт объём планирования модели. Качество изображения настраивается отдельно.
Объективно о важном
Маркетинговые и продуктовые команды могут быстрее пробовать варианты визуальных материалов и добавлять анимацию в кампании.
Бизнес-процессы
Создание рекламных и продуктовых материалов — Быстрые варианты изображений и GIF могут ускорить подготовку макетов.
Возможности автоматизации
Создание и правка визуалов через API: Можно встроить генерацию, разметку правок и экспорт в процесс подготовки материалов. Условия: Выбор Flare или Sunburst, качества и сложности зависит от задачи; использование API тарифицируется.; Перед публикацией нужна проверка содержания и соответствия бренду.
Влияние на ручную работу
Часть подготовки и правки макетов можно передать модели, но экономия ручного труда в конкретном процессе не подтверждена.
Ограничения и риски
Скорость зависит от варианта модели и настроек; заявленные показатели принадлежат OpenAI.
Результаты и экспортированные файлы следует проверять перед использованием.
OpenAI испытала агентный поиск уязвимостей ядра Linux
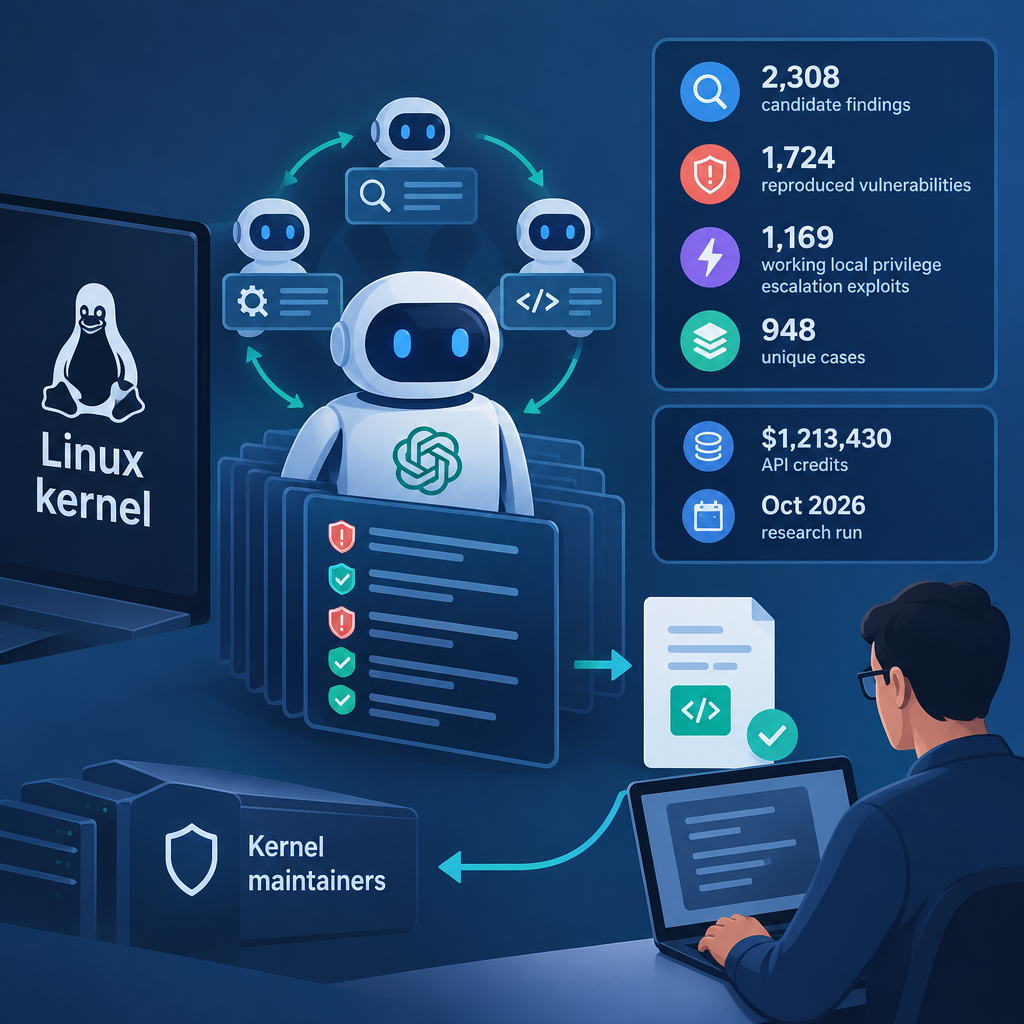
OpenAI опубликовала результаты испытания прототипа в контролируемой среде. Он использует ИИ-агентов — программы, выполняющие многошаговые задачи, — для поиска и проверки уязвимостей и подготовки исправлений. Результаты затем проверяют специалисты.
Ключевые факты
По данным OpenAI, система проанализировала 2 308 потенциальных находок и воспроизвела 1 724 уязвимости. Она также создала 1 169 работающих эксплойтов для локального повышения привилегий. Число уникальных случаев компания оценивает в 948 — по числу различных исправлений для лежащих в их основе уязвимостей.
По данным OpenAI, испытание с будущей моделью для задач безопасности, проведённое в середине октября 2026 года, обошлось в $1 213 430 в API-кредитах. Компания начала отправлять разработчикам ядра отчёты и предлагаемые исправления для критических уязвимостей.
Объективно о важном
Исследование показывает возможный способ обрабатывать большой поток находок, но одновременно подчёркивает стоимость проверки и нагрузку на специалистов и сопровождающих проекта.
Бизнес-процессы
Аудит безопасности и подготовка исправлений — Воспроизведение уязвимостей и оценка возможности их эксплуатации могут помочь расставлять приоритеты.
Возможности автоматизации
Поиск, проверка и подготовка исправлений: Агенты могут формировать доказательства и проекты исправлений для последующей проверки людьми. Условия: Прототип использует ещё не выпущенную модель; общедоступность такого процесса не подтверждена.; Нужны изолированная среда, независимая проверка результата и проверка исправлений специалистами.
Влияние на ручную работу
В исследовании агенты выполняли поиск, воспроизведение и подготовку проектов исправлений, однако специалисты проверяли результаты. Сокращение затрат труда не измерено.
Ограничения и риски
Результаты и затраты приведены самой OpenAI для конкретной конфигурации исследования.
В раннем испытании 20 из 200 успешных эксплойтов использовали не назначенную уязвимость; затем OpenAI добавила независимую проверку.
Проекты исправлений могут быть неполными или создавать другие проблемы; находки также стоит перепроверять на актуальном коде.
Google поделилась методикой оценки ИИ для здравоохранения
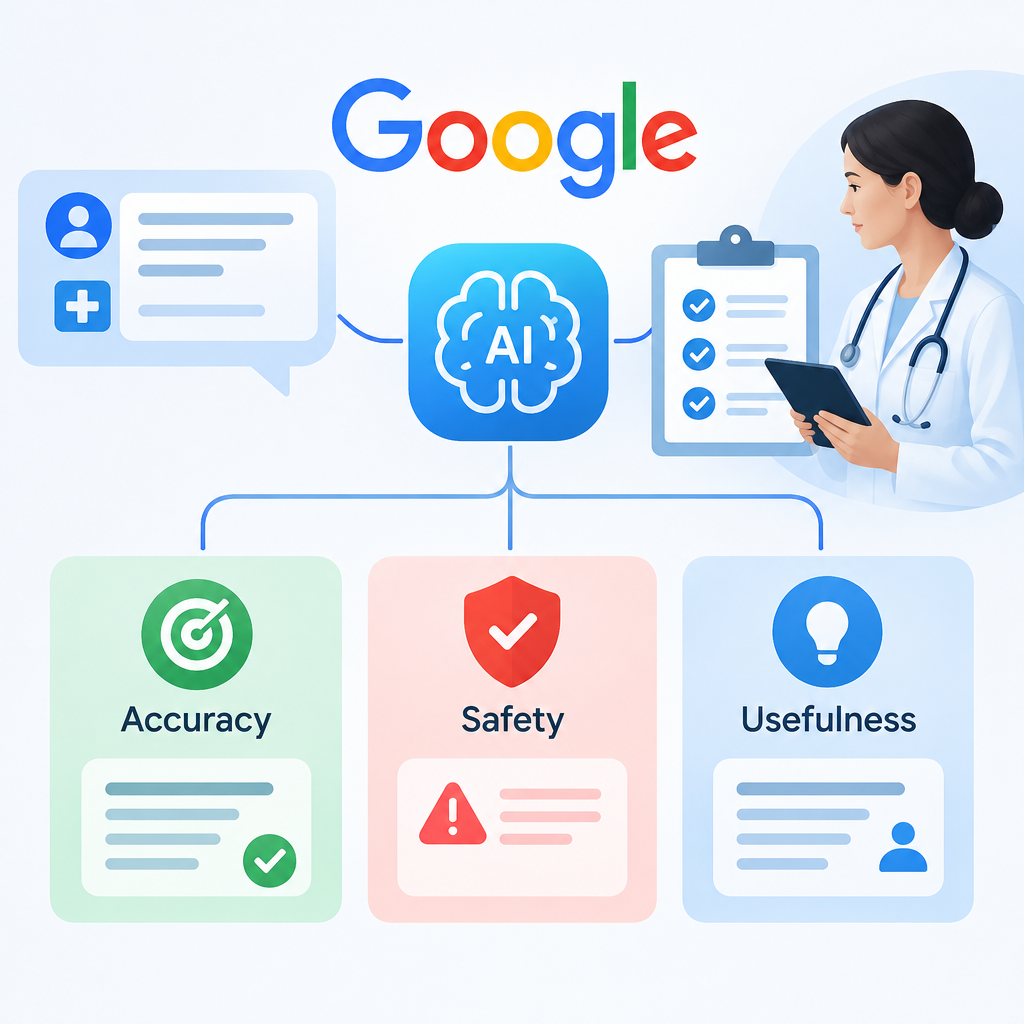
Google совместно с экспертами в области здравоохранения опубликовала методику оценки применения ИИ по трём направлениям: точность, безопасность и полезность.
Ключевые факты
Методика сочетает тесты с закрытыми вопросами, автоматическую оценку ответов и проверку профильными экспертами для распространённых сценариев и ситуаций с высоким риском.
Google сообщает, что использует эту методику для оценки ответов своих моделей на вопросы о здоровье.
Объективно о важном
Разработчики ИИ-инструментов для здравоохранения получают пример того, как сочетать масштабируемые тесты с экспертной проверкой вопросов безопасности.
Бизнес-процессы
Контроль качества ИИ-инструментов для здравоохранения — Команды могут организовать оценку ответов по точности, безопасности и полезности.
Возможности автоматизации
Оценка ответов ИИ: Автоматические оценщики могут помочь проверять ответы наряду с экспертами. Условия: Методика опубликована, но внедрение другими организациями не подтверждено.; Сценарии с высоким риском требуют участия профильных экспертов.
Влияние на ручную работу
Автоматическая оценка может взять на себя часть проверок, но её влияние на трудозатраты не измерено.
Ограничения и риски
Публикация не приводит результаты независимой проверки методики или доказательства безопасности конкретного продукта для здравоохранения.
Автоматическая оценка не заменяет экспертную проверку.