ИИ в расследовании угроз, исследовательские агенты и защита выборов
Дата выпуска:
В выпуске — три внутренних применения ИИ: разбор сигналов безопасности в Block, длительные исследования агентов Third Moment Research и выявление злоупотреблений Claude в избирательном контексте. Во всех трёх случаях автоматизация сочетается с проверкой или разбором результатов человеком.
Выпуск может включать ранее опубликованные важные события.
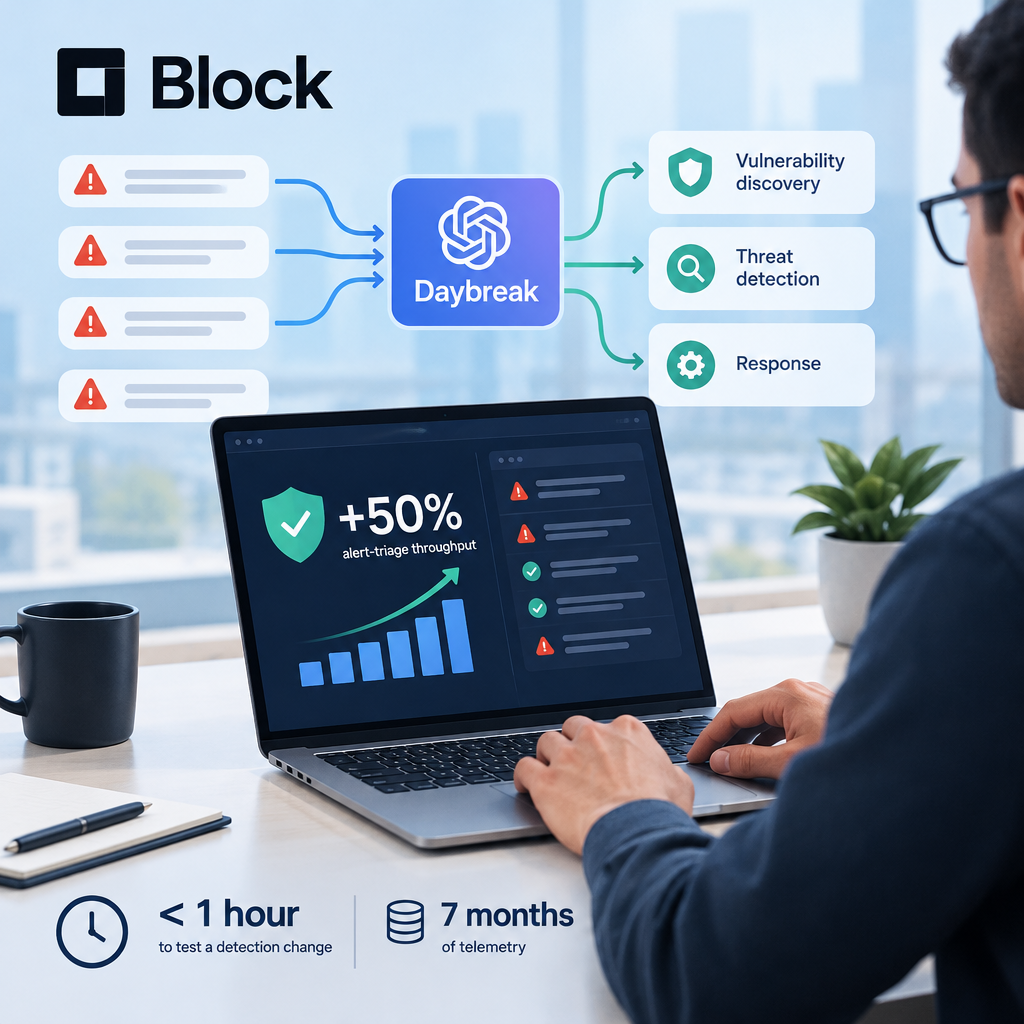
Block сообщает о росте скорости разбора сигналов безопасности на 50%
Block использует систему на базе OpenAI Daybreak для поиска уязвимостей, обнаружения угроз и реагирования на них. Она помогает разбирать предупреждения и готовить расследования. По сообщению Block, пропускная способность первичного разбора выросла на 50%. Компания подчёркивает, что каждый результат проверяет человек: автоматизация не принимает за команду все решения по безопасности.
Ключевые факты
Block сообщает о росте пропускной способности разбора предупреждений на 50%; объём сбора сведений об угрозах и расследований, по её данным, также вырос на 50%.
По данным Block, предложенное изменение правила обнаружения можно проверить менее чем за час на телеметрии, накопленной за семь месяцев. Раньше для такой проверки приходилось вручную повторять запросы по сотням старых случаев.
Как описано в материале OpenAI, система направляет задачи подходящим моделям, позволяет человеку перехватить работу и предусматривает взаимную проверку агентов. Block оценивает её по внутренним тестам и результатам работы.
Block сообщает, что в недавних учениях её красной команды путь от описания уязвимости до автоматически предложенного исправления занимал 18 минут. Это время до предложения, а не до проверки и внедрения исправления.
Объективно о важном
Первичный разбор определяет, какие сигналы требуют внимания аналитика. Проверка новых правил на прошлых данных может ускорить их настройку и показать, какие случаи они затронут, прежде чем правила начнут применяться. Но найденная связь между записями разных систем ещё не доказывает наличие атаки. Приоритет инцидента, выводы расследования и исправление кода требуют контекста, которого у агента может не быть.
Бизнес-процессы
Разбор предупреждений и расследование инцидентов — Система может собрать записи из разных источников и подготовить связную картину случая. Это способно сократить повторяющийся поиск для аналитика, но собранные доказательства нужно проверить.
Настройка правил обнаружения и исправление уязвимостей — Историческая телеметрия помогает проверить предложенное правило. Для исправлений Block описывает отдельные шаги: установить, где находится проблема и кто отвечает за код, подтвердить возможность эксплуатации и проверить результат.
Возможности автоматизации
Сбор данных по предупреждению и подготовка расследования: Агент может сопоставить журналы и составить для аналитика проверяемую сводку. Человек сохраняет право перехватить задачу, оценить вывод и принять решение о дальнейших действиях. Условия: Описано внедрение внутри Block, а не подтверждённая доступность готового решения для других организаций.; Необходимы ограничения доступа к журналам, контроль качества собранных данных и правила передачи неоднозначных случаев человеку.; Маршрутизацию задач между моделями и результаты проверки на исторических данных следует оценивать в собственной среде.
Влияние на ручную работу
По оценке Block, автоматизация разбора ложных срабатываний высвободила около 600 часов работы аналитиков за квартал. Это показатель одного внутреннего внедрения из материала OpenAI, а не подтверждённая экономия для других команд.
Ограничения и риски
Цифры опубликованы в материале поставщика технологии со слов Block; независимого сравнения с другими командами он не даёт.
Ошибочное объединение сигналов или пропущенный контекст могут изменить оценку инцидента. Block сохраняет проверку человеком и намерена расширять применение на более чувствительные системы постепенно.
Быстрое предложение исправления не означает, что его безопасность уже проверена: подтверждение уязвимости, проверка исправления и развёртывание остаются отдельными шагами.
Third Moment Research описывает одновременную работу 10 000 агентов
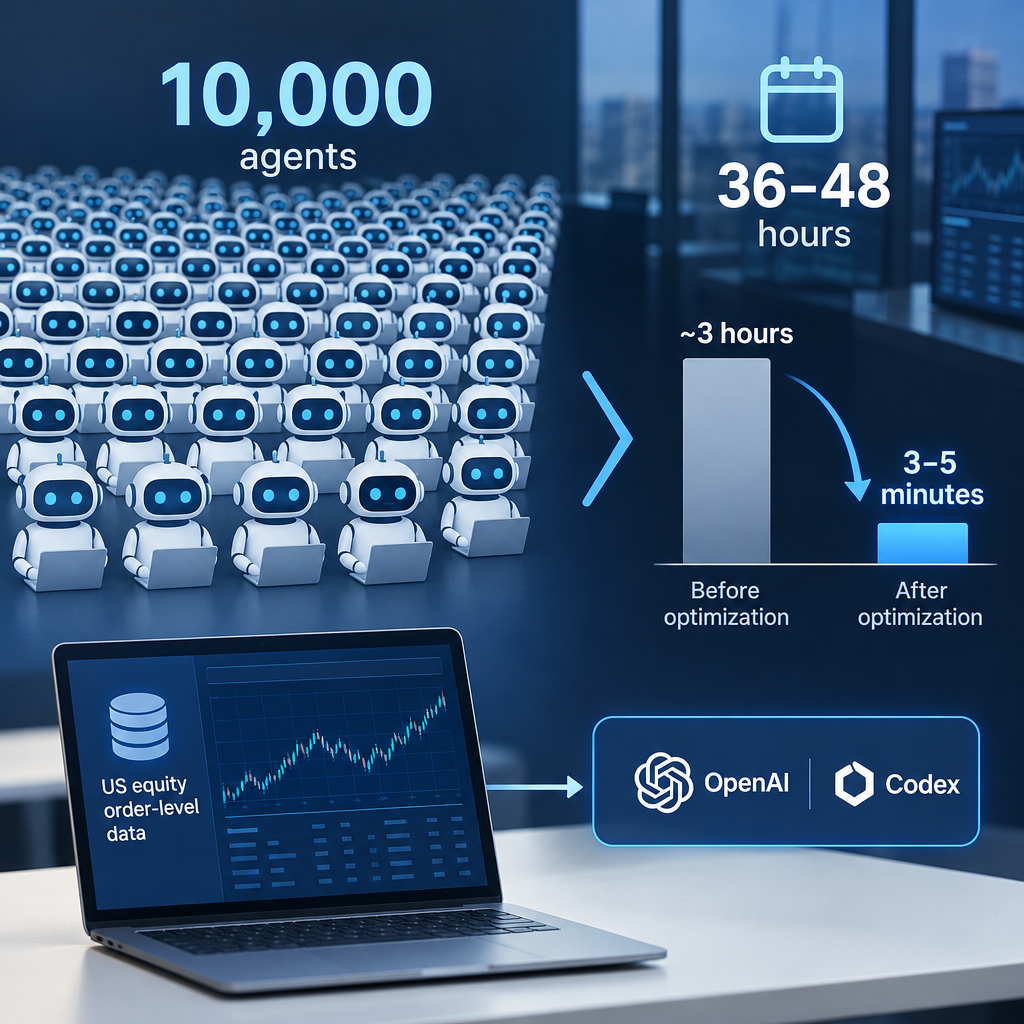
Third Moment Research сообщает, что одновременно запускает 10 000 агентов для исследований длительностью 36–48 часов. В её внутренней среде агенты используют модели OpenAI и инструменты Codex, в частности для проверки торговых стратегий на исторических данных. Компания также описала оптимизацию одного теста стратегии: после изменений в кэшировании и работе с памятью его время сократилось примерно с трёх часов до трёх–пяти минут.
Ключевые факты
По сообщению Third Moment Research, её система поддерживает одновременную работу 10 000 агентов над исследованиями, продолжающимися 36–48 часов.
Компания сообщает, что Codex помог найти задержку в тестировании стратегии на годовых данных о заявках по акциям США. После оптимизации тест, занимавший около трёх часов, стал выполняться примерно за три–пять минут.
Согласно описанию Third Moment Research, внешний управляющий слой разбирает незавершённые задания и решает, повторить попытку, остановить работу или передать её человеку.
Компания использует Daybreak для проверки безопасности среды перед запуском симуляций, в том числе для проверки того, может ли агент выйти за пределы исследовательской среды и получить доступ к сети.
Объективно о важном
Когда агенты работают сутками и запускают множество экспериментов, важны не только ответы моделей. Ожидание медленного теста может расходовать их вычислительный бюджет на повторные проверки статуса вместо исследования. Сокращение такого ожидания полезно именно для этой исследовательской среды; оно не доказывает, что найденная торговая стратегия окажется успешной. Кроме того, длительные задания нужно завершать, повторять или передавать человеку по понятным правилам.
Бизнес-процессы
Количественное исследование и тестирование стратегий на исторических данных — Агенты могут проводить последовательные эксперименты и выбирать следующий тест по предыдущему результату. Выводы нужно отделять от случайных закономерностей в прошлых данных.
Управление длительными заданиями агентов — Управляющий слой может заметить остановившееся исследование и направить его на повтор, завершение или проверку человеком, не оставляя незавершённую задачу без решения.
Возможности автоматизации
Параллельные эксперименты в изолированной исследовательской среде: Агенты могут запускать серию проверяемых тестов, а управляющий слой — отслеживать выполнение и передавать спорные результаты специалисту. Это возможный подход для задач с ясным способом оценки результата, а не обещание аналогичного масштаба в любой компании. Условия: Описана внутренняя система Third Moment Research; её доступность как готового решения для других организаций не заявлена.; Нужны изоляция среды, ограничения доступа и расходов, запись параметров экспериментов и проверка воспроизводимости.; Для финансового применения необходима независимая оценка результатов и соблюдение применимых требований.
Влияние на ручную работу
Third Moment Research сообщает о сокращении времени одного теста и расхода токенов во время ожидания. Публикация не даёт отдельной оценки сэкономленных часов ручной работы и не показывает, что такой эффект повторится в других организациях.
Ограничения и риски
Масштаб работы агентов и ускорение теста указаны компанией в материале OpenAI; независимых измерений для сравнения не приведено.
Проверка стратегии на исторических данных не подтверждает её результативность при реальной торговле. Быстрый расчёт может лишь ускорить получение ошибочного вывода.
При большом числе агентов возрастают затраты и риски доступа к данным и инфраструктуре; описанные проверки изоляции не устраняют необходимость постоянного контроля.
Anthropic добавила защиту Claude от многоэтапных злоупотреблений на выборах
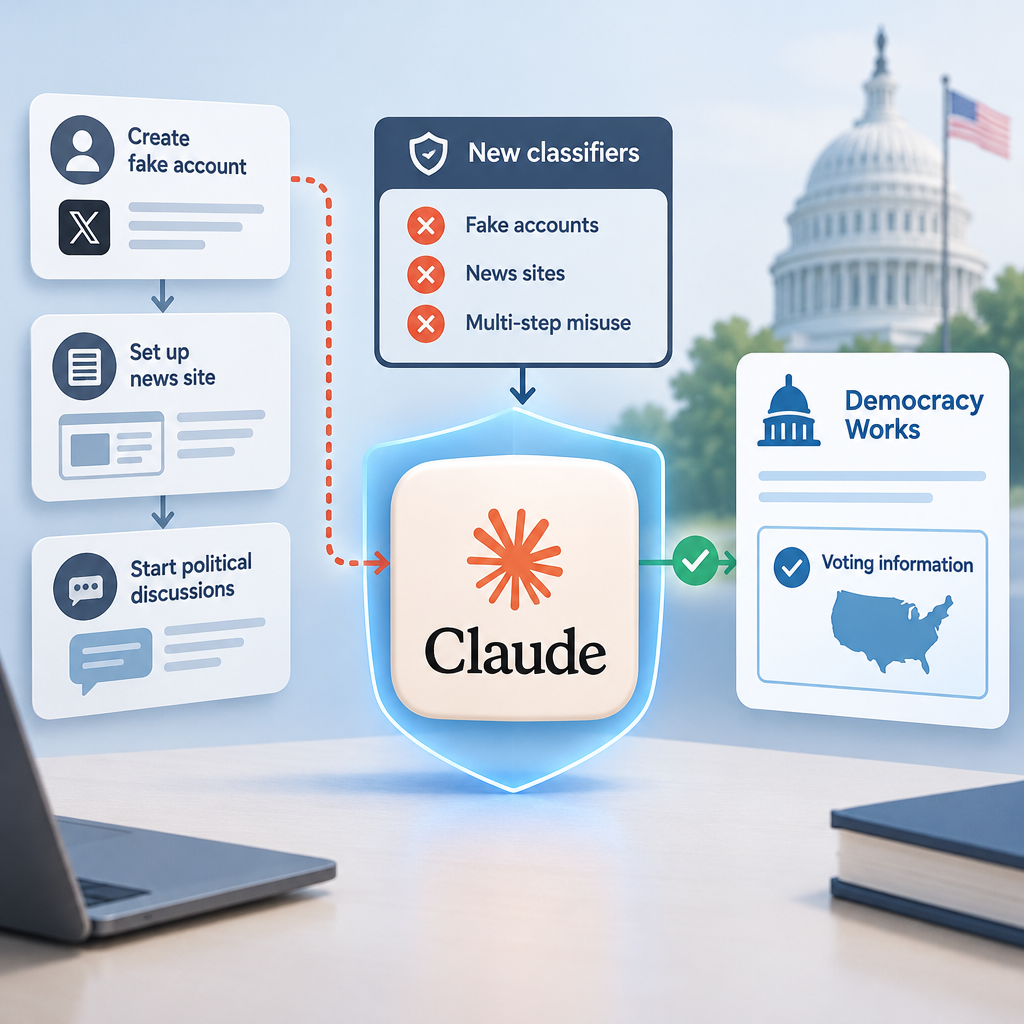
Anthropic сообщила о новых классификаторах для выявления злоупотреблений Claude, связанных с выборами. Их задача — лучше распознавать в том числе многоэтапные схемы, отдельные запросы в которых выглядят безобидно. Компания также анонсировала, что позднее в октябре Claude.ai начнёт включать в ответы сведения Democracy Works о голосовании для пользователей в США. Эта функция ещё не описана как запущенная.
Ключевые факты
Anthropic добавила классификаторы для выявления новых и многоэтапных схем, включая попытки создавать поддельные аккаунты в соцсетях и новостные сайты для политических обсуждений.
По сообщению Anthropic, исследователи Institute for Strategic Dialogue и McCain Institute обнаружили: Claude надёжно отклонял прямой вредоносный запрос, но мог не распознать кампанию, разбитую на внешне безобидные задания.
По данным Anthropic, её команды анализируют отмеченную системой активность и при подтверждении нарушения принимают меры, вплоть до блокировки аккаунтов.
Anthropic сообщает, что позднее в октябре Claude.ai начнёт использовать сведения Democracy Works из государственных и местных источников для ответов пользователям в США на вопросы о голосовании.
Объективно о важном
Проверка каждого запроса по отдельности может упустить цель цепочки действий: исследование аудитории, подготовка сайта и написание материалов не всегда выглядят опасно порознь. Описанные испытания объясняют, почему платформе нужны средства выявления многоэтапных схем. Это не означает, что новая защита распознает любую попытку обхода. Ошибочные сигналы тоже возможны, поэтому решение о нарушении требует разбора, а сведения о голосовании — проверки актуальности.
Бизнес-процессы
Выявление нарушений правил ИИ-платформы — Классификаторы могут направлять на рассмотрение случаи, похожие на подготовку кампании по обману избирателей. Специалисты должны проверить контекст, прежде чем применять меры к аккаунту.
Предоставление справочной информации о голосовании — Claude.ai уже показывает ссылку на TurboVote при вопросах о регистрации, участках и датах выборов. Добавление сведений Democracy Works непосредственно в ответы для пользователей в США Anthropic планирует позднее в октябре.
Возможности автоматизации
Выявление многоэтапных злоупотреблений Claude, связанных с выборами: Автоматическая проверка может выделять подозрительную активность для дальнейшего расследования командой платформы. Это пример внутренней защиты Anthropic, а не доступного сторонним организациям классификатора. Условия: Anthropic сообщает о добавлении классификаторов в собственную защиту Claude; сторонняя доступность не заявлена.; Нужны разбор отмеченной активности и проверка предполагаемого нарушения до блокировки аккаунта.; Запланированное включение сведений Democracy Works в ответы Claude.ai относится к пользователям в США; оно не является уже запущенной частью этих классификаторов.
Влияние на ручную работу
Классификаторы могут помочь отбирать случаи для проверки, но Anthropic не приводит показатель сокращения ручной работы. Компания указывает, что её команды рассматривают отмеченную активность и подтверждают нарушения.
Ограничения и риски
Испытания выявили слабость прежней защиты при дроблении кампании; публикация не доказывает, что новые классификаторы выявят все подобные схемы.
Описание касается защиты самой платформы Claude, а не готового продукта для модерации чужих сервисов. Возможны пропуски и ошибочные срабатывания.
Официальные сведения о голосовании в ответах для пользователей в США запланированы на более поздний срок. В таких ответах особенно важны точность и актуальность исходных данных.