Cyber Mission Anthropic, агенты Sophos MDR и браузерный агент StackAI
Дата выпуска:
В выпуске — программы Anthropic для защиты критической инфраструктуры и открытого кода, использование агентов в сервисе Sophos MDR и оптимизация браузерного агента StackAI у Asana. Численные результаты Sophos и Asana приведены в публикациях OpenAI со слов компаний; переносить их на другие условия без проверки нельзя.
Выпуск может включать ранее опубликованные важные события.
Anthropic представила Cyber Mission для критической инфраструктуры и открытого кода
Ранее опубликованное событие ·
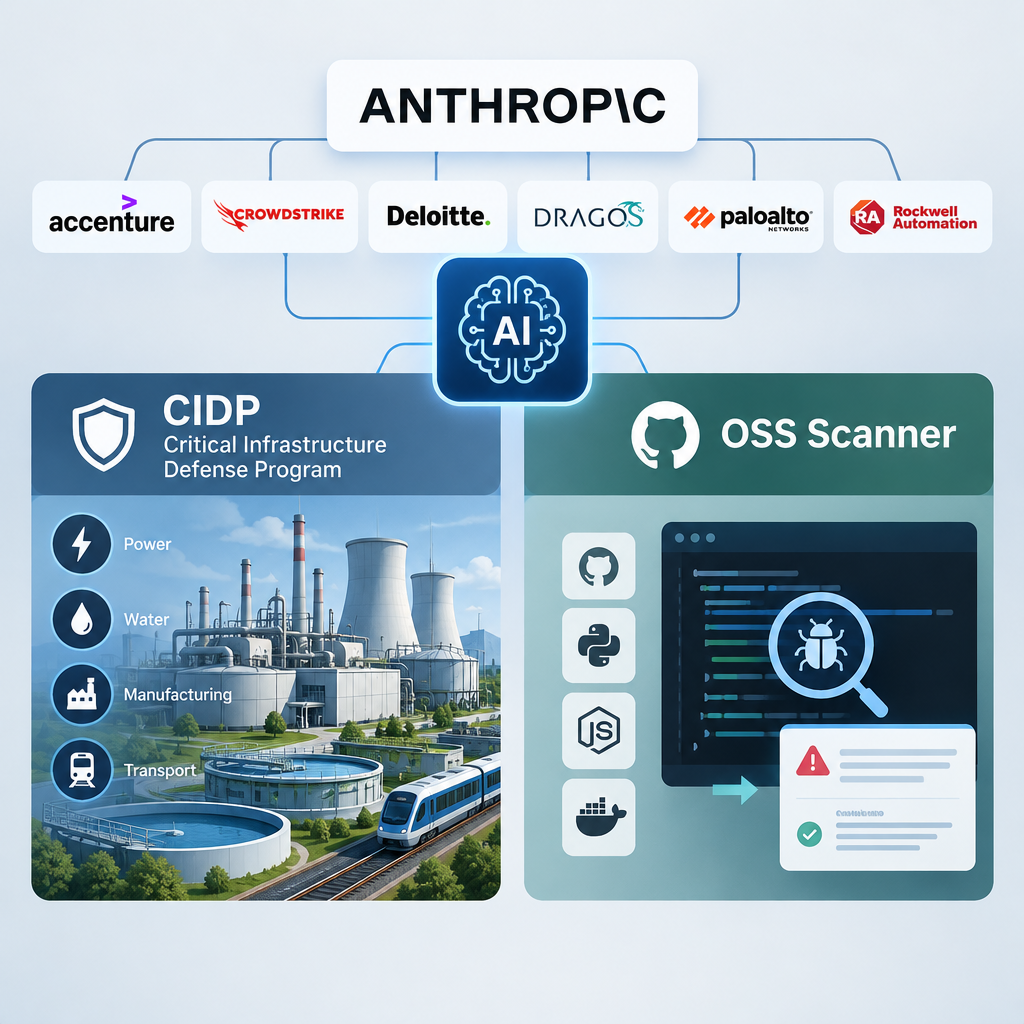
Anthropic представила долгосрочную инициативу Cyber Mission с двумя направлениями. Critical Infrastructure Defense Program (CIDP) объединяет модели Claude, инженеров на площадках и исследования угроз для поставщиков, защищающих операционные технологии — системы управления оборудованием и промышленными сетями. Второе направление, OSS Scanner, — бесплатное сканирование подключившихся проектов с открытым кодом. Его отчёты создаёт модель; перед отправкой их не проверяет человек.
Ключевые факты
Работа CIDP уже идёт с частью партнёров. Anthropic начинает с небольшой группы поставщиков услуг и оборудования для критической инфраструктуры, а не с открытого доступа для всех операторов.
OSS Scanner периодически отправляет подключившимся проектам отчёты с описанием ошибки, примером возможной эксплуатации и предложением исправления, если оно доступно. Сервис рассчитан на команды, способные разбирать поступающие находки.
Anthropic ожидает долю верных срабатываний OSS Scanner выше 90%, но предупреждает, что непроверенные отчёты могут ошибаться, в том числе в оценке серьёзности уязвимости.
Для проектов, которым не подходит поток непроверенных отчётов, Anthropic намерена сохранять раскрытие уязвимостей после проверки человеком в рамках своей процедуры согласованного уведомления.
Объективно о важном
Инициатива касается двух разных узких мест. В инфраструктуре уязвимое оборудование порой нельзя остановить ради обновления: специалистам нужны оценка риска и безопасный план изменений. В открытом коде сканирование может ускорить обнаружение возможных ошибок, но одновременно увеличит очередь на проверку. Anthropic прямо отмечает, что подтвердить, расставить по приоритету и исправить находки сложнее, чем просто их получить.
Бизнес-процессы
Управление уязвимостями промышленного оборудования — Партнёры CIDP могут быстрее готовить данные о слабых местах для специалистов, которые решают, когда и как безопасно менять работающую систему.
Сопровождение проектов с открытым кодом — Периодические отчёты добавят кандидатов на проверку и исправление; нагрузка на сопровождающих может как сократиться при удачной фильтрации, так и вырасти.
Возможности автоматизации
Сканирование и первичная сортировка сообщений об уязвимостях: Подключить подходящий проект к OSS Scanner, направлять отчёты в очередь проверки и передавать подтверждённые ошибки сопровождающим. Автоматическое исправление не входит в заявленные возможности сервиса: Anthropic описывает его как дальнейшую цель. Условия: Подключение добровольное; команда должна располагать ресурсами для разбора находок.; Перед исправлением или раскрытием сведения модели нужно подтвердить, включая серьёзность ошибки и пригодность предложенного патча.
Подготовка проверки уязвимостей критической инфраструктуры: Поставщики, участвующие в CIDP, могут использовать Claude и исследования угроз для поиска слабых мест и подготовки вариантов устранения; решение об изменениях остаётся за профильными специалистами. Условия: На первом этапе Anthropic работает с небольшой группой партнёров.; Изменения на действующем оборудовании требуют проверки безопасности; их нельзя выводить из ответа модели и применять автоматически.
Влияние на ручную работу
Сканирование может уменьшить объём ручного поиска потенциальных ошибок. Подтверждение находок, выбор приоритета, уведомление и безопасное исправление остаются работой людей; сокращение этих трудозатрат не измерено.
Ограничения и риски
Ожидаемая доля верных срабатываний выше 90% — прогноз Anthropic, а не опубликованный результат независимой проверки.
Отчёты OSS Scanner отправляются без проверки человеком и могут содержать неверную оценку серьёзности или другие неточности.
Поток сообщений может перегрузить небольшую команду сопровождающих; сервис ориентирован на проекты с ресурсами для разбора.
Поиск уязвимости в операционных технологиях не означает, что её можно быстро устранить без риска для работающего объекта.
Sophos сообщила о результатах агентов OpenAI Daybreak в MDR
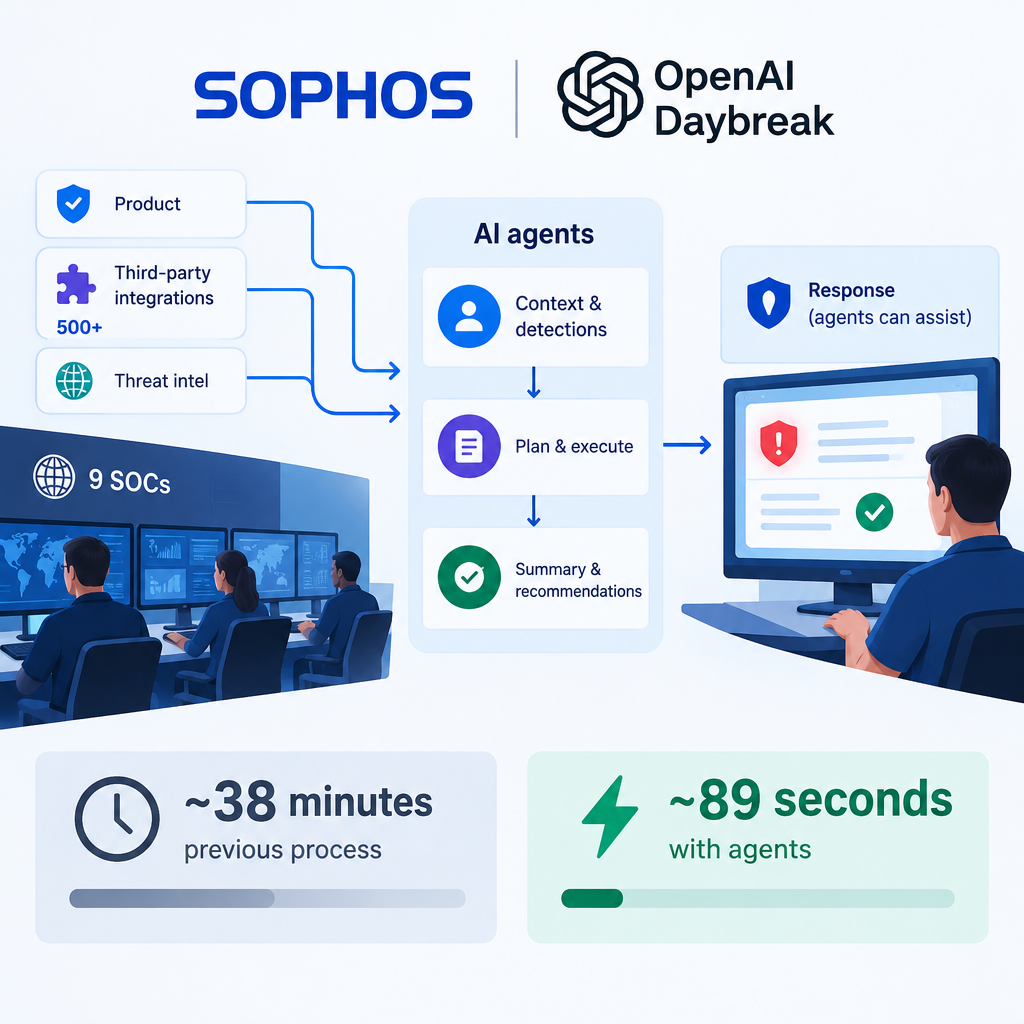
Sophos использует агентов, созданных в программе OpenAI Daybreak, в сервисе управляемого обнаружения угроз и реагирования — MDR. Один агент собирает сведения о клиенте, срабатываниях и угрозах. Модель планирования составляет план расследования, выполняет его шаги и готовит итог с рекомендациями для аналитика; другие агенты могут выполнять часть ответных действий. По данным Sophos, среднее время реагирования на случаи с агентами составляет около 89 секунд против примерно 38 минут в прежнем процессе.
Ключевые факты
По описанию OpenAI, Sophos сводит данные собственных продуктов и более 500 сторонних интеграций в случаи для расследования девятью центрами мониторинга безопасности.
Sophos сравнивает среднее время своего прежнего процесса — около 38 минут — с примерно 89 секундами для случаев, где применяются агенты. Публикация не описывает это как контролируемое сравнение одинаковых групп случаев.
Sophos сообщает, что ИИ полностью разрешает 52% случаев MDR в границах, настроенных её аналитиками. Это показатель доли случаев, а не времени обработки всей очереди.
У клиентов есть режимы Notify, Collaborate и Authorise: от получения рекомендации до разрешения Sophos действовать от их имени. Те же границы полномочий действуют для людей и агентов.
Объективно о важном
Здесь автоматизируется цепочка расследования, а не только составление текста: сбор контекста, план, выполнение шагов и передача решения. Это может освобождать аналитиков для сложных угроз и исключений. Но скорость не показывает, насколько верны выводы и безопасны ответные меры. Действовать за клиента агент может лишь в пределах выбранного режима; потенциально разрушительные действия требуют надлежащего контроля человеком.
Бизнес-процессы
Расследование случаев в MDR и центре мониторинга безопасности — Агенты могут собрать разрозненные данные и подготовить проверяемый итог до участия аналитика; Sophos сообщает об ускорении случаев, в которых их применяет.
Реагирование на обнаруженную угрозу — Часть разрешённых шагов может выполняться быстрее, если понятны полномочия клиента и условия передачи случая человеку.
Возможности автоматизации
Сбор контекста и подготовка расследования: Собирать сигналы, индикаторы компрометации и сведения об угрозах, затем представлять аналитику выполненные шаги и рекомендуемые действия. Описанное внедрение относится к Sophos, а не к готовому универсальному процессу для любого центра безопасности. Условия: Нужны пригодные данные, интеграции и утверждённые сценарии расследования.; Рекомендации и нестандартные случаи следует направлять на проверку согласно риску и политике клиента.
Разрешённые ответные действия MDR: Передавать агентам только те шаги, на которые клиент дал полномочия в выбранном режиме обслуживания; остальные оставлять человеку. Условия: Режим Notify предполагает действие клиента, Collaborate — совместное решение, Authorise — возможность Sophos действовать от его имени.; Потенциально разрушительные действия и случаи вне допустимых границ требуют контроля или решения специалиста.
Влияние на ручную работу
Sophos сообщает о действующем внедрении и полном разрешении агентами 52% случаев MDR. Это свидетельство поставщика о снижении ручной нагрузки в его процессе; публикация OpenAI не содержит независимого измерения эффекта.
Ограничения и риски
Цифры 89 секунд и 52% приведены Sophos в публикации OpenAI; независимой проверки результатов нет.
Сравнение времени относится к прежнему процессу и случаям с агентами, а не доказывает такое же ускорение для каждого типа угроз.
Sophos передаёт людям случаи, которые не считает допустимым поручать агенту; полномочия на действия зависят от режима клиента.
Агенты не заменяют базовые меры защиты: установку исправлений, многофакторную аутентификацию и сегментацию сети.
Asana выпустила изменения для браузерного агента StackAI
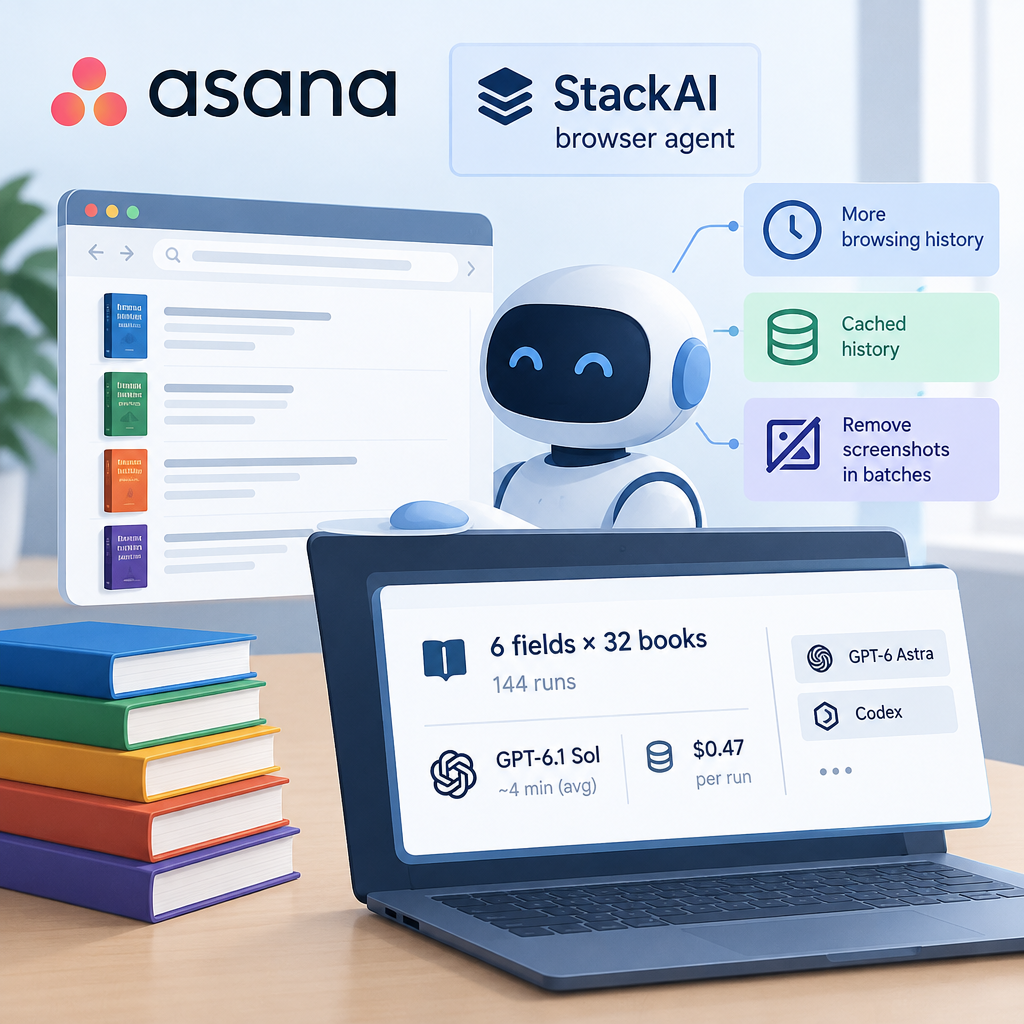
Asana выпустила изменения для браузерной навигации в StackAI: агент дольше сохраняет историю просмотренных страниц, использует кэш для этой истории и удаляет снимки экрана группами, а не после почти каждого шага. По опубликованному описанию, технический директор StackAI руководил экспериментами с GPT-6 Astra в Codex. В испытаниях конфигурация на GPT-6.1 Sol выполняла тестовую задачу в среднем примерно за четыре минуты при оценочной стоимости работы модели $0,47 за запуск.
Ключевые факты
Asana выпустила изменения для браузерного агента StackAI после испытаний кэширования истории, объёма сохраняемого текста и порядка удаления снимков экрана.
По данным Asana, исследование включало 144 запуска четырёх моделей. Каждая конфигурация решала одну задачу: собрать по шесть полей для 32 книг из открытого демонстрационного каталога.
Asana оценила среднюю стоимость модели для оптимизированного процесса на GPT-6.1 Sol в $0,47 и время — примерно в четыре минуты на запуск: в 76 раз дешевле и в пять раз быстрее прежней производственной конфигурации на Model B.
Asana также сообщает, что при большем лимите истории все 18 соответствующих запусков на GPT-6.1 Sol дали верный ответ, тогда как при меньшем лимите ответ был получен лишь в трёх из 18 запусков.
Объективно о важном
Если браузерный агент повторно отправляет модели накопленные тексты страниц и снимки экрана, каждый шаг может дорожать. При этом частое удаление старых материалов меняет историю, мешает использовать кэш и способно лишить агента нужных сведений. Испытание Asana показывает, зачем оценивать стоимость, скорость и завершение задачи вместе. Результат сравнения нельзя приписывать только кэшированию: в итоговой конфигурации изменились и рабочий процесс, и модель.
Бизнес-процессы
Сбор данных и действия в веб-приложениях — Более бережная работа с историей может снизить расходы и задержки при навигации и извлечении сведений, если задача похожа на проверенную.
Эксперименты и тестирование программного обеспечения — Агент может запускать варианты конфигурации и готовить материалы для инженерной команды; Asana также использует GPT-6 Astra для поиска ошибок до выпуска функций.
Возможности автоматизации
Настройка стоимости и качества браузерного агента: Испытывать лимит истории, кэширование и удаление снимков на реальных сценариях команды, сравнивая не только цену запроса, но и завершение задачи. Условия: Проверять результаты на собственных сайтах и данных: опубликованные показатели относятся к одной задаче с каталогом книг.; Учитывать стоимость модели, время, правильность ответа и риск потери полезного контекста одновременно.
Проверка новых функций агентом до выпуска: Запускать агентные сессии с разными входными данными, чтобы они проходили интерфейс и передавали сообщения об ошибках специалистам по качеству. Условия: Asana сообщает об использовании такого подхода, но инструменты для повторяемых экспериментов ещё разрабатывает.; Сообщения агента об ошибках требуют проверки человеком; испытание оптимизации не измеряло качество этого процесса.
Влияние на ручную работу
По оценке технического директора StackAI, работа с GPT-6 Astra заняла около недели вместо предполагаемых одного-двух месяцев вручную. Это оценка участника проекта, а не независимое измерение сэкономленного труда.
Ограничения и риски
144 запуска относятся к вариантам одной задачи; такое же ускорение и снижение затрат для других сайтов не показано.
Сравнение «в 76 раз» объединяет смену модели и изменение процесса; вклад каждого фактора в общий результат нужно оценивать отдельно.
Прежние запуски на Model B иногда достигали лимита шагов до завершения, поэтому их опубликованная средняя стоимость — нижняя граница.
$0,47 — оценочная стоимость работы модели, а не подтверждённая полная стоимость эксплуатации; результаты опубликованы заинтересованными сторонами.